故障智巡复盘——AI 故障排查,为什么必须「只读取证 + 人工审批」
故障智巡复盘——AI 故障排查,为什么必须「只读取证 + 人工审批」
仓库:ydflow/incident-response-agent · TypeScript
一句话:从故障信号到可核查的处置决策。
一、背景:AI 做运维,最危险的是「它动手了」
让 AI 去查线上故障,直觉上很有吸引力,但有一个致命问题:AI 如果「自作主张」地重启服务、改配置、回滚版本,出事了算谁的?
故障智巡从这个最尖锐的问题出发,定下了一个几乎「反直觉」的基调:调查全程只读,处置必须经过人工审批。
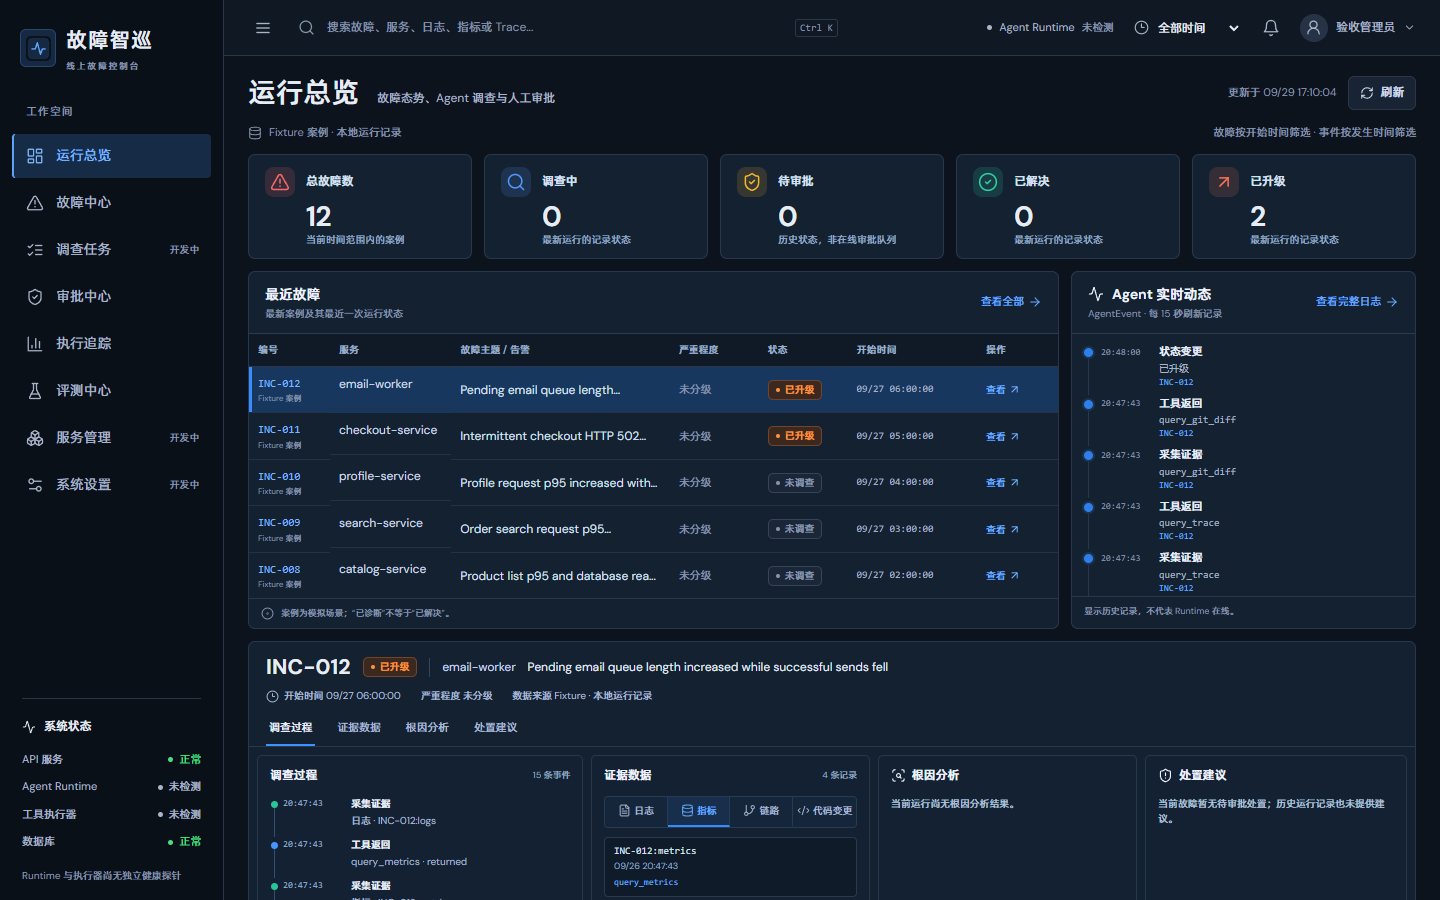
以 Incident 为中心组织调查:通过只读工具采集日志、指标、链路与变更,形成可追溯的 Evidence;诊断必须引用已收集的证据。
二、核心设计:只读取证 + 证据链 + 审批门控
1. 只读取证,先找证据再下诊断
调查的第一步不是「让模型回答」,而是只读采集:
- 日志、指标、链路、变更,通过只读工具采集;
- 每条诊断必须引用已收集的证据,不能空口下结论;
- 证据冲突或不足时,流程升级人工复核。
这背后是一个根本的立场:AI 的价值是「把证据找齐、把关联理清」,而不是「拍脑袋给结论」。
2. SAFE / ASK / BLOCK 三级审批门控
涉及处置的 ToolCall,必须先经过策略分级:
| 级别 | 含义 | 处理 |
|---|---|---|
| SAFE | 安全,可直接执行 | 自动放行 |
| ASK | 需确认 | 由可信宿主审批 |
| BLOCK | 危险 | 直接阻止 |
高风险动作交给「审批中心」:只展示当前 Gate 中有效的 ASK 请求,历史审批只读呈现,BLOCK 根本不进队列。「能不能做」和「敢不敢做」被彻底分开。
3. AgentEvent / JSONL 可回放
关键状态与决策写入 AgentEvent / JSONL,可以按历史事件只读回放——像看监控录像一样还原「当时发生了什么、为什么这么决策」。Replay 不会再次调用模型、工具或执行器,纯只读。
三、v0.3.0 的演进:从 Fixture 到「现场」
早期版本靠 Fixture(模拟案例)验证,v0.3.0 迈出了关键一步——接入真实的本地受控数据源:
1 | 受控真实请求 → 有界阈值规则 → 认证 Webhook → SQLite 投递幂等/故障窗口聚合 |
几个值得讲的工程点:
- 投递键与聚合键分离:服务/环境/指纹/时间窗口隔离,SQLite 事务 + 唯一约束 + 租约 fencing + 有限重试。
- 现场 Provider 与 Fixture 不混用:Trace/Git 明确标注 unsupported,绝不静默回退到模拟数据。
- Runbook 与证据分开:BM25 检索的 Markdown 手册是「调查步骤」,不是「当前观测证据」,两者在界面上分列。
四、诚实的验收:把「没做到」也写清楚
这是故障智巡最打动我的地方——它把边界写得极其诚实:
| 能力 | 当前状态 |
|---|---|
| 真实模型诊断 | 已配置 Provider,但本轮有限 E2E 请求超时,保存实际观测并升级人工,最终模型诊断未通过 |
| 恢复验证 | 8 次恢复请求成功,验证 verified,但调查仍 ESCALATED,不自动 RESOLVED |
| 生产接入/处置 | 未接入、未验证;现场调查无动作执行器或外部通知 |
「模型超时」不是隐藏的失败,而是被保留为失败原因、可回放的记录。恢复验证通过 ≠ 调查已解决,两者分开处理。
质量方面:全仓 TypeScript 3087 passed、Python 72 passed,移动端 9 passed。
五、几点复盘
- AI 运维的第一原则是「别乱动」。只读取证 + 人工审批,把风险锁死在流程里,比任何「智能」都重要。
- 证据链是可信的基石。诊断必须引用证据,证据必须能点开检查,缺数据必须显式标注——这条链断了,AI 结论就是空话。
- 诚实验收比漂亮数字重要。真实模型诊断「未通过」、恢复「未自动解决」都如实写出,这才是能继续前进的姿态。
- Fixture 和现场要严格隔离。演示数据和真实数据一旦混用,所有「通过」都会失去意义。
这个项目回答了一个我很关心的问题:Agent 在「高后果场景」里,如何既发挥价值,又守得住边界。 下一篇讲剪映自动化 Skill,你会看到同一套「可靠第一」的思路,如何落到一个完全不同的领域。